用 SIFT + RANSAC 做尺寸校准,以及怎么判断「对得准不准」
上一篇 讲到,SIFT 加 ratio test 能给出一批候选匹配,但里面仍可能混着少量错误匹配。这一篇接着解决实际问题:把一张被缩小过的图对齐回原图尺寸,并且判断这次对齐到底靠不靠谱。
为了让结果可复现,本文的演示图都是在一张公开测试图(768×900)上人为构造的:先在原图上叠两块文字,再把不带文字的版本缩小到 0.87 倍,模拟「处理后叠加文字没了、分辨率也变了」的情况。因为缩放比是我自己设定的,所以可以检验方法能不能把它找回来:期望的放大倍数是 \(1/0.87 \approx 1.1494\)。
从一堆匹配点,怎么得到缩放比?
如果两张图之间只差一个均匀缩放(可能带一点旋转和平移),对应点满足相似变换:
\[\begin{pmatrix} x' \\ y' \end{pmatrix} = \begin{pmatrix} a & -b \\ b & a \end{pmatrix} \begin{pmatrix} x \\ y \end{pmatrix} + \begin{pmatrix} t_x \\ t_y \end{pmatrix}, \qquad a = s\cos\theta,\; b = s\sin\theta\]一共 4 个自由度:缩放 \(s\)、旋转 \(\theta\)、平移 \(t_x, t_y\)。每对匹配点提供 2 个方程,所以理论上 2 对点就能解出整个变换。
OpenCV 的 estimateAffinePartial2D 估计的就是这种变换,返回一个 2×3 矩阵,缩放比和旋转角直接从里面读:
src = np.float32([kp_small[m.queryIdx].pt for m in good]).reshape(-1, 1, 2)
dst = np.float32([kp_orig[m.trainIdx].pt for m in good]).reshape(-1, 1, 2)

M, inliers = cv2.estimateAffinePartial2D(src, dst)   # 默认 method=RANSAC
a, b = M[0, 0], M[1, 0]
scale = np.hypot(a, b)                     # s = sqrt(a² + b²)
angle = np.degrees(np.arctan2(b, a))       # θ

restored = cv2.warpAffine(small, M, (orig.shape[1], orig.shape[0]))
注意方向:这里把小图的点映射到原图,所以得到的是「放大回去」的倍数,约等于 \(1/0.87\)。
如果图像之间还有透视变化(比如裁剪后又被拉伸),相似变换就不够了,要换成 cv2.findHomography(..., cv2.RANSAC),它有 8 个自由度。
在演示图上跑出来的结果:
| 项目 | 数值 |
|---|---|
| 关键点数 | 带文字原图 3010 / 缩小图 2112 |
| ratio test 后候选匹配 | 1566 对 |
| RANSAC 内点 | 1542(98.5%) |
| 估计缩放比 | 1.1494(真值 1.1494) |
| 估计旋转角 | 0.0001°(真值 0) |
缩放比精确命中。注意内点率高达 98.5%,这是因为我的叠加文字只占画面很小一块,大部分画面在两张图里是完全对应的。真实的生成式模型输出改动更大,内点率会低不少。
RANSAC 为什么能无视错误匹配?
最小二乘会让每个点都参与拟合,几个离谱的外点就能把结果拉歪。RANSAC(RANdom SAmple Consensus)的思路是让点投票:
- 随机抽最少数量的点(相似变换只需要 2 对),解出一个候选变换。
- 用这个变换去映射所有点,数一数有多少点的误差小于阈值,这些点就是这个候选的内点。
- 重复很多次,保留内点最多的那个候选。
- 最后只用这批内点做一次精细拟合。
外点之间没有共识,凑不成多数派;正确匹配都指向同一个真实变换,自然成为多数。OpenCV 的默认内点阈值是 3 像素(ransacReprojThreshold=3),选出内点后还会用 Levenberg–Marquardt 迭代细化,最小化内点的重投影误差平方和。
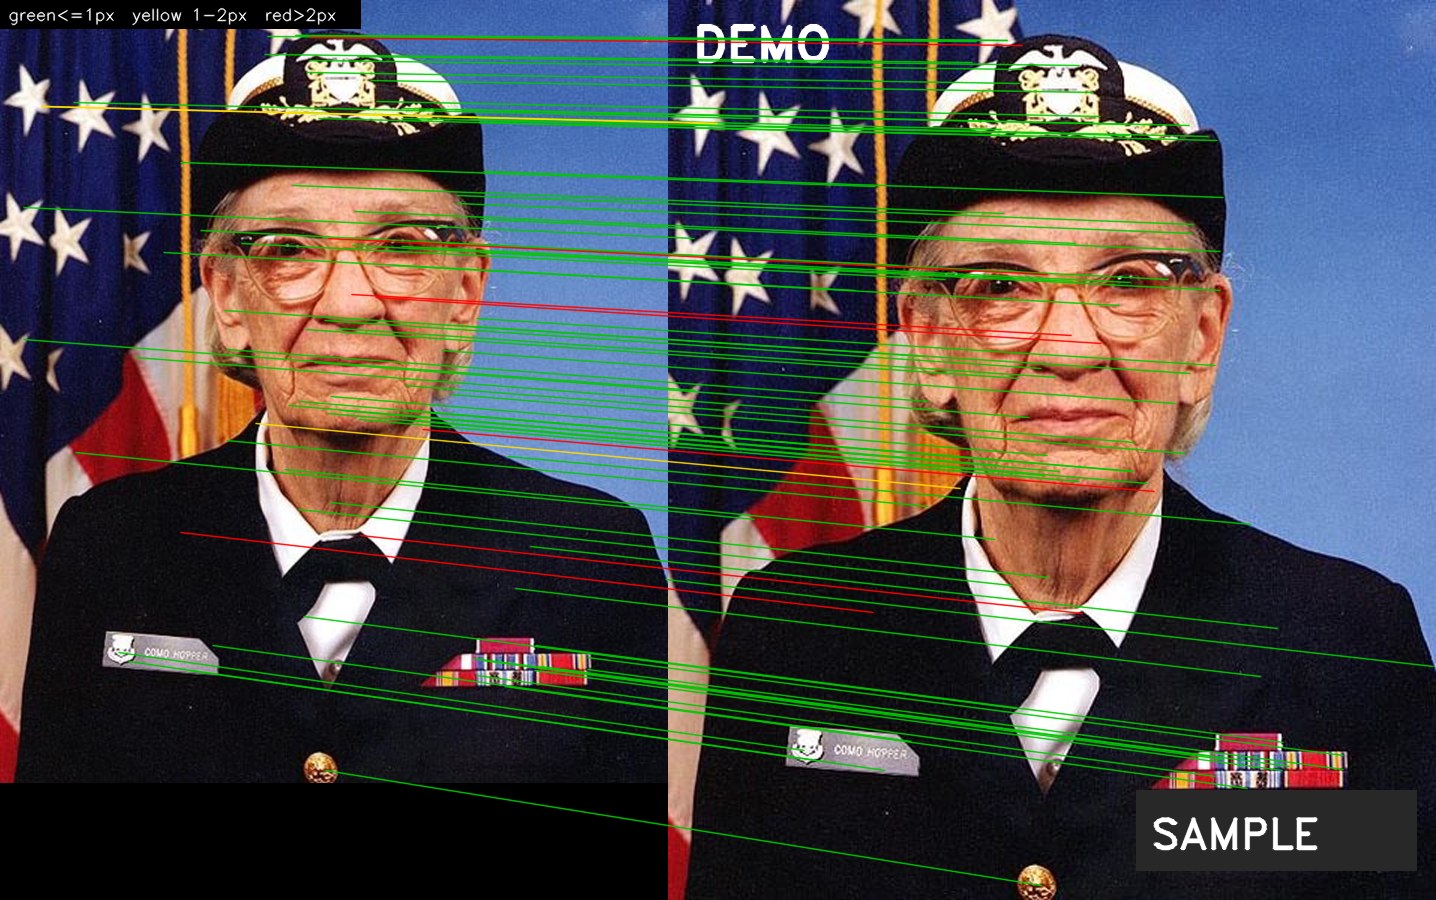
把内点连线按残差染色后,可以看到文字区域几乎没有连线穿过。文字上的点在 ratio test 那一步就被丢掉了,零星混进来的错配也会在 RANSAC 里被投票淘汰。
绘图时要注意抽稀。内点有一千多个,全画出来会糊成一片色块,什么也看不出来。随机抽几十条、再强制保留残差最大的那几条,图才有信息量。
SIFT 的误差大概有多大?
「SIFT 的误差」不是一个数,不同环节的误差含义完全不同:
- 定位精度:关键点做了亚像素插值,在干净图像上可以到亚像素级。但尺度空间是分层离散采样的,插值只能部分弥补。
- 描述子的有损性:16×16 的邻域被压成 128 个直方图 bin,丢失了细节;光照、模糊、局部内容改动都会让描述子漂移。距离最近不等于位置完全一致。
- 重复纹理的歧义:草地、条纹上很多点长得几乎一样,容易错配,或被 ratio test 保守地丢掉。
- 场景本身的变化:比如生成式处理改动了局部内容,那片区域的匹配要么消失,要么位置偏一点。
对于尺寸校准,最直接的指标是 RANSAC 内点的重投影误差:把一张图的点用估出来的变换映射过去,看它离实际匹配位置差多少像素。
在我这个合成例子里(变换是干净的均匀缩放,只有局部的文字改动),内点残差的统计是:
| 指标 | 数值 |
|---|---|
| RMS | 0.32 px |
| 平均(MAE) | 0.19 px |
| 中位数 | 0.11 px |
| 最大值 | 2.78 px |
| 内点覆盖跨度 | 1171 px(图像对角线 1183 px) |
真实场景的误差会大得多:图像之间除了缩放还有压缩、局部内容改动、光照变化,残差通常在一两个像素甚至更高。这些数值会随纹理、分辨率和改动程度大幅波动,应当当作量级参考,而不是固定常数。
RMS、中位数、最大残差分别有什么含义?
先定义第 \(i\) 对内点的残差:
\[r_i = \left\lVert M(\mathbf{p}_i) - \mathbf{q}_i \right\rVert_2\]其中 \(\mathbf{p}_i\) 是小图上的点,\(\mathbf{q}_i\) 是它在原图上的匹配点,\(M\) 是估出来的变换。这样得到一串 \(r_1, \dots, r_N\),三个指标就是对它的三种概括:
| 指标 | 公式 | 公式的结构决定了它看什么 |
|---|---|---|
| RMS | \(\sqrt{\frac{1}{N}\sum r_i^2}\) | 先平方再平均:一个 4 px 的点贡献 16,抵得上 16 个 1 px 的点,所以对少数大误差很敏感 |
| 中位数 | 排序后取中间值 | 只看排名,两端的极端值不参与,对离群点几乎免疫,代表最典型的点 |
| 最大值 | \(\max_i r_i\) | 只看一个点,代表最坏情况 |
还有一个容易混淆的量:平均绝对误差 \(\text{MAE} = \frac{1}{N}\sum r_i\)。数学上总有 \(\text{RMS} \ge \text{MAE}\),并且
\[\text{RMS}^2 = \text{MAE}^2 + \operatorname{Var}(r)\]RMS 比 MAE 多出来的部分,就是误差分布离散程度的贡献。
为什么不需要真实缩放比,也能用它们判断对齐质量?
这里要区分两个统计学概念:
- 精度(precision):数据彼此之间有多一致。
- 准确度(accuracy):离真值有多近。
残差只用到了「两张图的匹配点」和「拟合出的变换」,全程没有输入任何真实缩放比。所以它衡量的是精度,本质上是一个自洽性检验:
是否存在一个统一的缩放比,能同时把每一对匹配点都对上?
如果两张图之间真的是一次干净的均匀缩放,所有正确匹配都服从同一个 \(s\),残差只剩亚像素级的噪声,RMS 就小。如果残差大,说明「单一缩放」这个假设站不住:要么图像之间还有局部变形或非均匀拉伸,要么匹配被污染了。无论哪种,估出来的 \(s\) 都不可信。
可以类比给吉他调音。用音叉校准绝对音高,相当于拿真值比;不用音叉、只让弦与弦之间互相和谐,相当于自洽性检验。后者能告诉你这把琴内部是否一致,但严格来说证明不了绝对音高是对的。
从三个数字读出结论
单看一个数字信息有限,看它们之间的差距才有用。下面是一个示范推导。
以上面实测的那组为例:中位数 0.11 px、平均 0.19 px、RMS 0.32 px、最大值 2.78 px。
- RMS 大于平均,平均又大于中位数:误差分布右偏,存在一小撮偏得多一些的点,但大多数点都在 0.1 px 量级。
- 最大值是 RMS 的 8 倍多:说明确实有少数点明显偏离,不过它贴着 RANSAC 的内点阈值,属于「勉强及格」那一档(见下面的折叠说明)。
- 内点覆盖跨度 1171 px,接近图像对角线 1183 px:点铺满了整张图。
- 结论:整体干净,缩放比可信。
再看一组假设的数据:中位数 1.4、RMS 1.5、最大值很大。
- 平均值(以及 RMS)对离群点敏感,中位数不敏感。两者几乎相等,说明拉高平均值的离群点数量很少,即「尾巴很薄」。
- 最大值远大于 RMS,说明这少数几个点偏得很远,即「尾巴很长」。
- 合起来就是:大量好点里混了极少数坏点。这通常对应某个小的局部坏区,比如被模型改动过的叠加文字附近。
RMS 的平方结构还能帮你估数量级。假设把内点阈值放宽到 30 px 后做统计,大部分点的残差仍在 1.4 px 左右(平方约 1.96),而 RMS² 是 2.25,那么一个 30 px 的点(平方 900)要被稀释到这个程度,内点总数大约得有三千个。一个坏点能被多少好点淹没,可以直接从平方和里反推。
❌ 一个容易忽略的细节:内点的最大残差有上限
上面「最大值远大于 RMS」的例子在默认参数下其实很难出现。RANSAC 判定内点的标准就是残差小于阈值(OpenCV 默认 3 px),所以内点的最大残差基本被这个阈值封顶。最后的细化会让变换稍微移动,残差可能略微超过阈值,但不会出现 30 px 这种数字。
我这次实测也印证了这一点:RMS 0.32 px、中位数 0.11 px,而最大值 2.78 px,正好贴着默认的 3 px 阈值。最大值在这里反映的是「阈值附近还剩多少勉强及格的点」,不是坏点有多坏。
所以读数字之前,要先弄清楚统计的是哪批点:
- 如果只统计内点,最大残差主要反映阈值附近还剩多少「勉强及格」的点。
- 想看真正的坏点,应该看外点数量和它们在图上的位置,或者把阈值放宽后再统计。
把这些规则收拢成一张表:
| 观察到的组合 | 结论 |
|---|---|
| 中位数 ≈ 平均,最大值 ≈ RMS(都小) | 整体干净 |
| 中位数 ≈ 平均,但最大值 ≫ RMS | 极少数坏点,整体仍可信,去定位那块区域 |
| 中位数 ≪ 平均 | 坏点成片出现,要警惕整体退化 |
| 内点太少或挤在一小块 | RMS 再小也不能说明估计稳定,见下一节 |
RMS 很小,就一定对得准吗?
不一定。精度高不等于准确度高。下面三种情况,残差可以很小,估计却不可靠:
- 匹配太少:只有五六个点时,残差小很容易是「点不够多,约束不足」的结果,而不是变换真的对。
- 匹配挤在一小块:变换在那一小块内部拟合得很好,但对画面其余部分几乎没有约束,一外推就容易错。缩放比尤其依赖点之间的距离,点挤在一起时,微小的定位误差会被放大成明显的缩放误差。
- 所有点共享同一个系统偏差:所有点一起偏,彼此仍然一致,残差照样小。
这里需要说得准确一点:点少又挤在一起,不一定就估错,但估计会变得不稳定。
我在演示图上做了个蒙特卡洛实验,从同一批匹配里反复随机抽取子集来估缩放比,每种设置跑 400 次:
| 取点方式 | 点数 | 缩放比均值 | 标准差 | 最大相对误差 | 平均 RMS |
|---|---|---|---|---|---|
| 挤在画面一角(120 px 窗口内) | 6 | 1.1492 | 0.00256 | 0.79% | 0.26 px |
| 铺满整张图 | 6 | 1.1495 | 0.00078 | 0.71% | 0.20 px |
| 铺满整张图 | 20 | 1.1494 | 0.00027 | 0.11% | 0.27 px |
三组的均值都接近真值 1.1494,RMS 也都很小。真正的差别在标准差:
- 同样 6 个点,挤在一角时标准差是铺开时的 3 倍多;
- 点数从 6 增加到 20 并铺开,标准差又降到约三分之一。
也就是说,残差小只说明「这几个点彼此一致」,不保证估计稳定。换一组点,挤在一角的那个结果可能飘得多得多。而且这还是在变换完全干净的合成数据上,真实数据里一旦混进系统性的局部形变,少量聚集的点就更容易被带偏。
所以 RMS 必须和这几个量一起看:
- 内点数量;
- 内点率;
- 内点在画面上的覆盖范围,比如内点坐标外接框的对角线长度,和图像对角线相比是多少。
内点多、铺得开、残差小,三者同时成立,才能相信估出来的缩放比。
批量对齐时该看哪些数字?
批量处理时,给每一对图记录这些列:
file, orig_size, small_size, scale, angle, good, inliers, inlier_rate, rms, median, max, span
然后按下面的规则筛出需要人工复查的样本:
- 缩放比和同批其他图明显不一致:如果同一批图应该是统一缩放的,偏离的那张很可能匹配有问题。也可能是那张图来源不同、根本没被缩放(比如缩放比恰好是 1、残差为 0,两张图逐像素相同)。
- 旋转角明显不为 0:说明不是纯缩放,需要换更一般的模型。
- 内点数太少、覆盖范围太小:对应上一节的退化情况。
- 内点率低本身不一定是失败:纹理少的画面(雪地、水面)匹配就是少,只要内点数够、铺得开、缩放比和同批一致,结果仍然可用。
这也是逐张估计的价值:不用假设所有图都乘同一个固定系数,每张图会按它自己的实际情况校准。
像素差热力图怎么读?
对齐回原尺寸后,可以逐像素比较两张图,看哪里被改动了:
diff = np.abs(a.astype(np.int16) - b.astype(np.int16)).max(axis=2)  # 三通道取最大
norm = cv2.normalize(diff, None, 0, 255, cv2.NORM_MINMAX).astype(np.uint8)
heat = cv2.applyColorMap(norm, cv2.COLORMAP_JET)   # 蓝 → 青 → 绿 → 黄 → 红
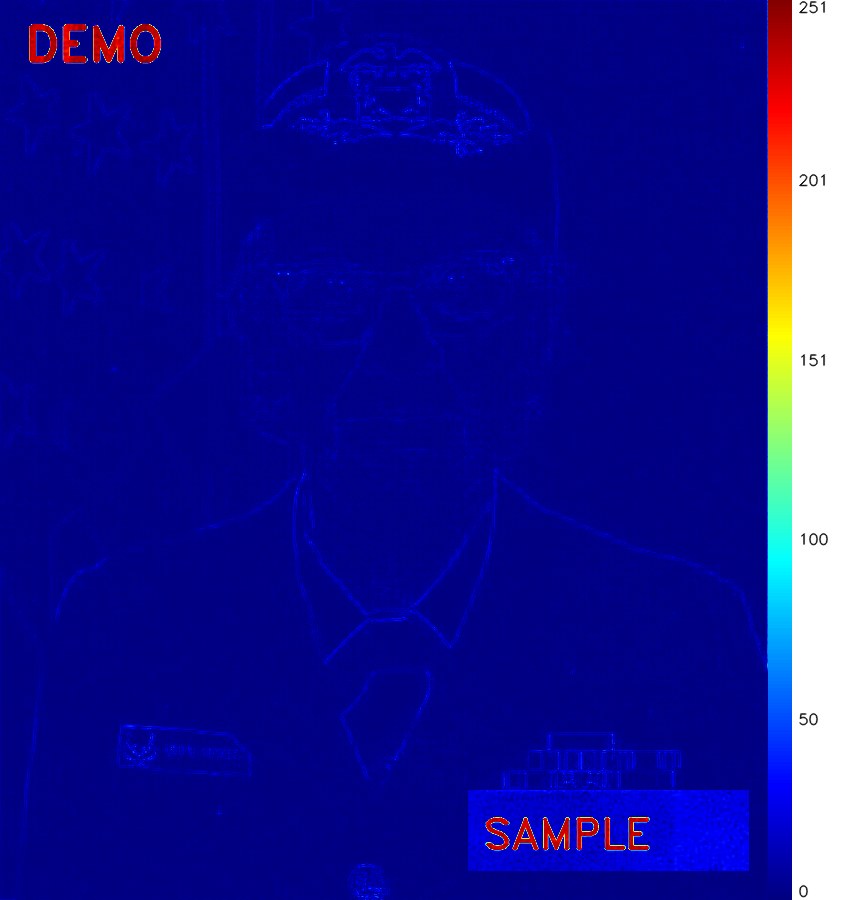
读法:
- 越暖的颜色差异越大。两张图完全一致时,整张图是同一种颜色。
- 但这里用了
NORM_MINMAX:颜色是本图内部的相对排名,红色只表示「这张图里差异最大的地方」,不对应固定的数值。
所以一定要配一根带真实数值的颜色条。即便有了颜色条,不同图之间的刻度也不一样,不能直接拿两张热力图比颜色深浅。如果需要横向比较,就用固定的 0–255 刻度,不做归一化。
这张热力图呈现出清晰的两层结构,和数字对得上(中位差 1、99 分位 32、最大 251):
- 大面积的蓝色来自重采样。缩小再放大会丢失高频信息,中位差只有 1/255,但在边缘和细节处能看到勾出的轮廓线。
- 两块暖色斑就是叠加文字所在的位置,差值接近 251,几乎是完全改变。
值得注意的是,中位差 1 在 0–251 的刻度上只占 0.4%,所以整张图看起来几乎是纯蓝的。如果换一对差异整体更大的图,同样的蓝色可能对应完全不同的绝对差值,这正是不能跨图比颜色的原因。
肉眼看已经对齐了,为什么下游模型效果还是变差?
这是我在项目里遇到的真实问题:几何上已经对齐得很好,关键点也都落在该在的位置,但生成式模型处理过的图交给分割模型,结果明显不如原图。
把像素差拆开看就能理解。几何对齐只保证「坐标对得上」,不保证「坐标下面的像素还是原来那批」。生成式模型处理图像时,改动的往往不只是叠加文字那一块,全图都可能有轻微的颜色和纹理变化。
这些变化对人眼来说很自然,几乎察觉不到;SIFT 只看少数关键点附近的粗粒度梯度直方图,也不太敏感。但深度分割模型读的是密集的像素特征,对这种纹理统计上的偏移(分布偏移)要敏感得多。
所以问题不在关键点的位置,而在图像内容。关于分割模型怎么使用提示和图像特征,可以看 SAM3 速览。
自测题
- 有一次对齐的 RMS 只有 0.2 px,但只有 6 个内点,而且全挤在画面左上角。你会信任这个缩放比吗?
参考答案
不该把它当作可靠结果。它同时命中两种退化情况:点太少,容易被错误的变换碰巧拟合;点挤在一角,对画面其余部分没有约束,而且点间距离小,定位误差会被放大成缩放误差。RMS 小在这里只说明「这 6 个点彼此一致」。
但也不要过度解读成「一定是错的」。上面的蒙特卡洛显示,在干净的变换下这种配置的均值仍然接近真值,变差的是稳定性(标准差大 3 倍多)。正确的做法是把它标记为待复查,而不是直接判定失败,也不是直接采用。
- 为什么 RANSAC 估相似变换时,每次只抽 2 对点?
参考答案
相似变换有 4 个自由度,每对点提供 2 个方程,2 对正好解出唯一解。抽的点越少,抽到的全是内点的概率越高,需要的迭代次数也越少。
- 两张热力图,一张最红的地方差值是 40,另一张是 230,它们的红色意义相同吗?
参考答案
不同。NORM_MINMAX 把每张图各自的最小值到最大值拉伸到整条色带,红色只代表「本图里最大」。要比较不同的图,需要看颜色条上的数值,或者改用固定的 0–255 刻度。
参考
- M. A. Fischler, R. C. Bolles. Random Sample Consensus. Communications of the ACM, 1981.
- D. G. Lowe. Distinctive Image Features from Scale-Invariant Keypoints. IJCV, 2004.
- OpenCV 文档:estimateAffinePartial2D
Enjoy Reading This Article?
Here are some more articles you might like to read next: