SIFT 自学笔记:尺度不变到底保证了什么
这篇笔记来自我在一个动物姿态数据集项目里的自学过程。起因很具体:一批图片经过一个生成式模型处理后,输出分辨率和原图不一致,需要把它们对齐回原图的尺寸,否则原图上标好的关键点就对不上动物了。有人建议「用 SIFT 配准一下」,于是我从零开始学 SIFT。
下面的小节按我当时实际追问的顺序排列,每个标题就是一个真实的问题。下一篇 用 SIFT + RANSAC 做尺寸校准 会接着讲怎么把匹配变成可信的缩放比。
SIFT 是什么,它基于什么原理?
SIFT 全称 Scale-Invariant Feature Transform(尺度不变特征变换),由 David Lowe 在 1999 年提出、2004 年在 IJCV 上完善。它做的事情可以概括成一句话:
在图里自动挑出一批有辨识度的点,给每个点配一张「身份卡」(描述子),让同一个物理位置在另一张缩放、旋转、亮度不同的照片里也能被认出来。
它背后有两个朴素的要求:
- 点要稳:图像放大、缩小、模糊之后,这个点仍然突出。
- 点要有身份:用一个对旋转和尺度不敏感的向量描述它,才能跨图比对。
为了满足这两点,SIFT 分四步走。
第一步:尺度空间极值检测。 用不同 σ 的高斯核把图像逐级模糊,相邻两级相减得到 DoG(Difference of Gaussians):
\[D(x, y, \sigma) = \big(G(x, y, k\sigma) - G(x, y, \sigma)\big) * I(x, y)\]每组(octave)内模糊若干级,之后把图像降采样一半再来一组,形成金字塔。一个像素要和同层 8 个邻居、上下两层各 9 个邻居共 26 个点比较,是极大或极小值才成为候选。Lowe 论文里的默认值是每组 3 个采样层、初始 σ = 1.6。
DoG 的意义在于它近似于尺度归一化的拉普拉斯 \(\sigma^2 \nabla^2 G\),后者的极值点对应「在这个尺度下最像一个斑点」的位置。所以每个关键点不仅有坐标,还自带一个尺度。
第二步:精确定位与筛点。 对候选点做二次插值拿到亚像素坐标,然后丢掉两类不稳定的点:对比度太低的(OpenCV 的 contrastThreshold),以及落在边缘上的(主曲率比超过阈值,论文里 r = 10)。边缘点沿边缘方向滑动时响应几乎不变,定位不稳。
第三步:主方向。 在关键点邻域内统计梯度方向直方图(36 个 bin,按梯度幅值和高斯权重加权),峰值就是主方向。超过最高峰 80% 的次峰会额外生成一个同位置、不同方向的关键点。后续描述子都在这个方向下计算,这就是旋转不变的来源。
第四步:128 维描述子。 取关键点周围 16×16 的区域(按尺度缩放、按主方向旋转),切成 4×4 个小格,每格统计 8 个方向的梯度直方图,拼成 \(4 \times 4 \times 8 = 128\) 维。向量会做归一化,截断大于 0.2 的分量后再归一化一次,以减弱光照变化的影响。
❌ 常见误解:「尺度不变」就是缩放后能检测出同一批点?
不是。图缩小一半后,检测到的关键点集合本来就会变:数量明显变少,分布也会改变。降采样会抹掉高频的细纹理,原来靠细纹理撑起来的关键点不再突出,就被淘汰了。
SIFT 承诺的是:对两边都存活下来的那些稳定地标,它们的描述子足够接近,能被匹配上。
(我最初观察到「原本在动物轮廓上的点,缩小后跑到了草地上」,后来发现主要原因并不在这里,而是代码 bug,见下一节的调试旁注。真实存在的现象和 bug 造成的现象要分开看。)
所以尺度不变是匹配层面的保证,不是检测层面的保证。检测负责多找候选,匹配负责跨尺度认出同一个点。
跑一遍:关键点长什么样?
用 OpenCV 只需要几行:
import cv2

img = cv2.imread("demo.jpg")
sift = cv2.SIFT_create()
keypoints, descriptors = sift.detectAndCompute(img, None)
print(len(keypoints), descriptors.shape)   # N 个点,(N, 128)

vis = cv2.drawKeypoints(img, keypoints, None,
                        flags=cv2.DRAW_MATCHES_FLAGS_DRAW_RICH_KEYPOINTS)
cv2.imwrite("keypoints.png", vis)
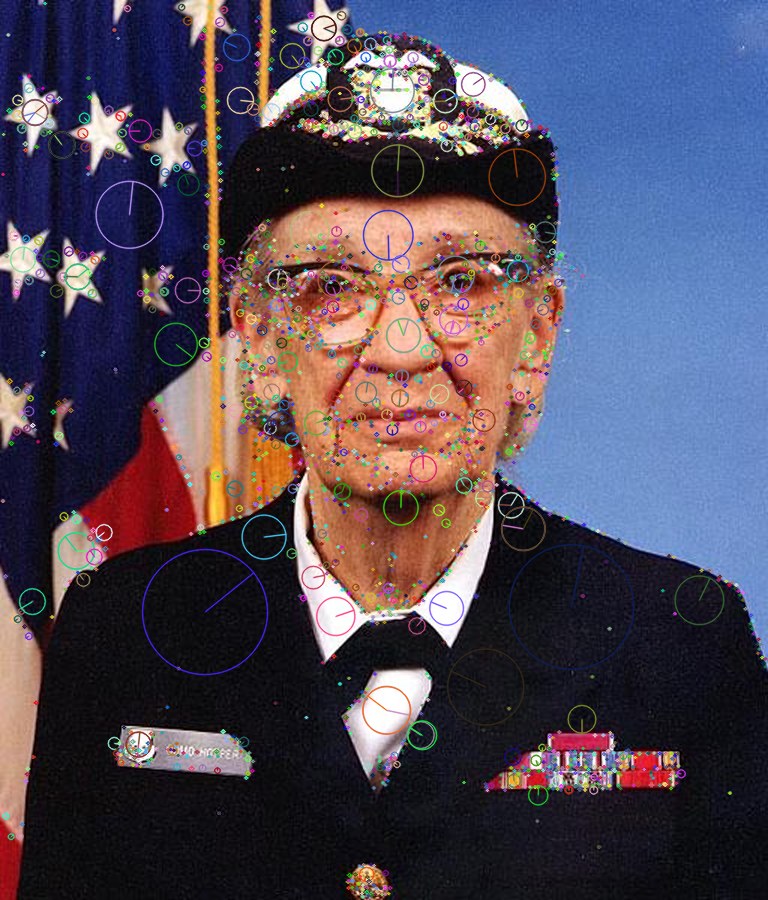
读图的方法:
- 每个圆是一个关键点,圆的大小就是它被检测到的尺度。大圆对应大块结构,小圆对应精细纹理。
- 圆里的半径线是主方向。
- 点集中在纹理丰富、明暗对比强的地方。平滑背景上几乎没有,因为那里换个角度也认不出来。
descriptors.shape 是 (N, 128):每行一个点,每行就是那张 128 维的身份卡。
调试旁注:缩小了图,关键点数量却一个没变
我第一次做「缩小一半再检测」的实验时,输出的关键点数和原图一模一样。问题出在两行代码的顺序:
keypoints, descriptors = sift.detectAndCompute(img, None)  # 先检测
img = cv2.resize(img, None, fx=0.5, fy=0.5)                # 后缩小
检测用的是缩小前的图,所以数量不变;而后面 drawKeypoints 又把原图坐标的点画到了缩小后的图上,圆圈自然「飘」到了别处。
教训是:先变换,再检测;检测用的图和画图用的图必须是同一张,坐标系要一致。 数字「完全没变」本身就是一个值得怀疑的信号。
接下来自然会问:既然跑了 100 次结果都一样,这算法里有没有「学」的成分?
SIFT 是固定的数学公式吗?
是。SIFT 是一条确定性的流水线:高斯模糊、差分、找极值、算梯度、拼直方图。同一张图、同样的参数,每次跑出来的关键点和描述子完全相同,里面没有任何可学习的权重。
它确实有几个人工设定的超参数,比如 nfeatures(保留多少个最强的点)、nOctaveLayers、contrastThreshold、edgeThreshold、sigma。这些是人调的配置,不是从数据里学出来的参数。
这正好可以和 CNN 对照:
| 手工特征(SIFT 等) | 学习特征(CNN 等) | |
|---|---|---|
| 特征从哪来 | 人按数学直觉设计 | 网络在训练中自己学 |
| 需要训练数据 | 不需要 | 需要大量数据 |
| 可解释性 | 每一步都能说清 | 较弱 |
| 表达能力 | 上限被设计者写死 | 能适配具体任务 |
很多老的视觉管线是「SIFT 找特征,再交给后续模型」。后来 CNN 把特征提取和任务一起端到端学掉了。补 SIFT,某种程度上就是补「CNN 之前大家怎么做」。
有了每个点的身份卡,下一个问题是:两张图之间到底怎么把点配对起来?
我们到底是怎么寻找匹配点的?
关键的一句话:
匹配不是在图像位置里找,而是在描述子空间里找。
两个点哪怕在画面上相隔很远,只要它们的 128 维向量足够接近,就被认为是同一个地标。具体分三步。
1. 算距离。 用欧氏距离衡量两张身份卡有多像:
\[d(\mathbf{a}, \mathbf{b}) = \sqrt{\sum_{k=1}^{128} (a_k - b_k)^2}\]2. 找最近邻和次近邻。 对 A 图的每个描述子,在 B 图的全部描述子里找距离最近的两个。点数不多时直接暴力比较即可,点多时可以用 FLANN 之类的近似最近邻加速。
bf = cv2.BFMatcher(cv2.NORM_L2)
knn = bf.knnMatch(des_a, des_b, k=2)          # 每个点要「最近 + 次近」两个候选
good = [m for m, n in knn if m.distance < 0.75 * n.distance]
3. Lowe ratio test。 只有当最近邻明显比次近邻更近时才接受这个匹配:
\[\frac{d_{\text{1st}}}{d_{\text{2nd}}} < \tau\]直觉是:草地、毛皮这类重复纹理里,很多点长得都差不多,最近和次近的距离会很接近,这种「险胜」不可信。在人群里认人也是这样:只有最像的那个人远比第二像的人更像,你才敢确认。
Lowe 在论文里用的阈值是 0.8,并报告这个阈值能剔除约 90% 的错误匹配,同时只丢掉不到 5% 的正确匹配。OpenCV 教程里常见的 0.75 稍严格一些。
在我这张演示图上(原图与缩小一半的图之间),阈值的影响很直接:
| ratio 阈值 | 通过的匹配数 |
|---|---|
| 0.6 | 562 |
| 0.75 | 646 |
| 0.9 | 1121 |
阈值放宽到 0.9,匹配数几乎翻倍,但多出来的那些正是「最近邻只比次近邻好一点」的可疑匹配。
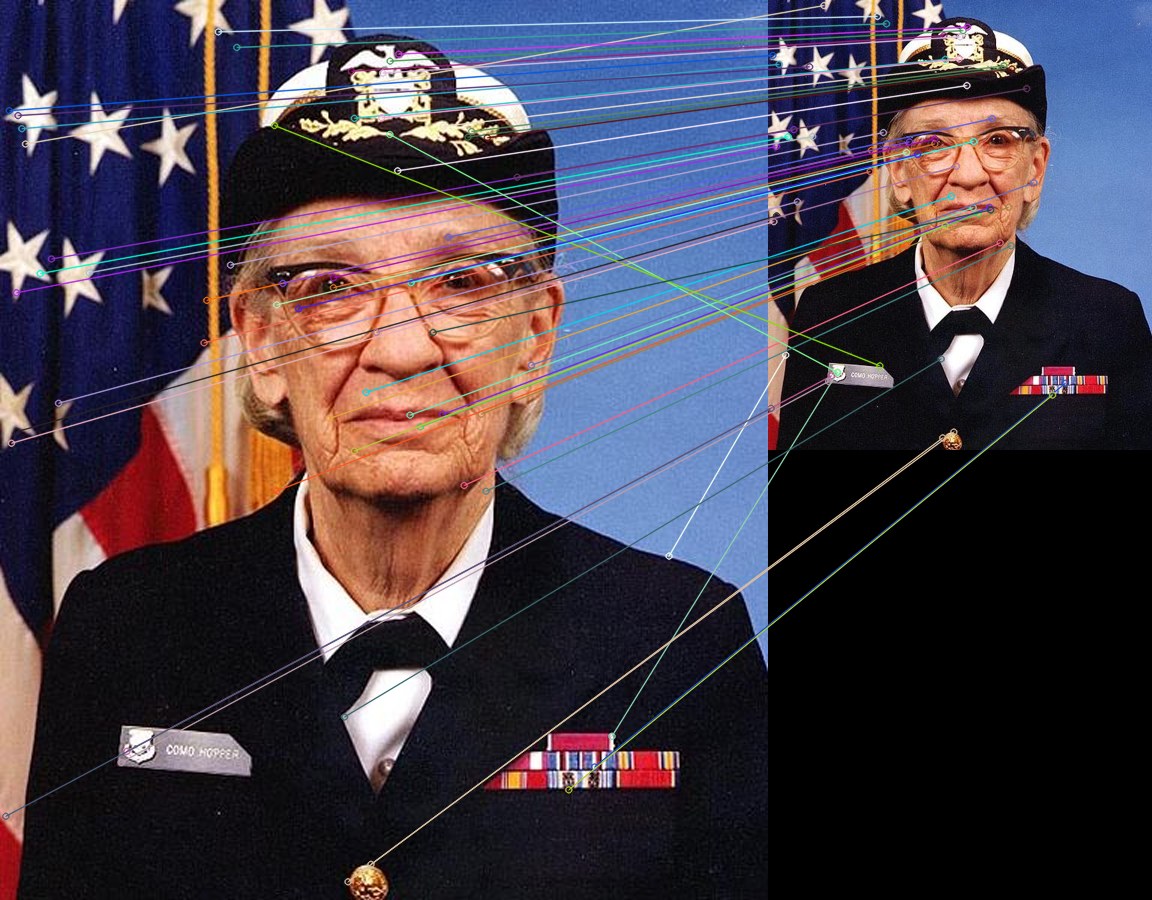
手动算一下这个距离,差距很明显。在这张图上,取第一对通过 ratio test 的匹配,两个描述子的 L2 距离约为 106;随机挑一个不相关的点来比,距离约为 490。「最近邻搜索」的含义就体现在这个差距上。
回到实际任务,就会遇到一个更麻烦的问题:两张图并不完全是同一张图的缩放。
一张图有叠加文字、另一张没有,会不会误匹配?
我的场景是:原图角落有叠加的文字(角标、时间戳一类的 overlay),边界非常清晰,SIFT 一定会在那里检测到大量关键点;处理后的图里这些文字不见了,那片区域变成了草地或天空,自然没有对应的点。担心的是这些点会不会配错,尤其是文字附近还有别的清晰边界。
需要区分两种边界:
- 叠加文字自身的边:只存在于原图。它们在另一张图里找不到足够像的对象,最近和次近候选都不像,ratio test 会把它们筛掉。结果是无匹配,不是误匹配。
- 文字附近的真实场景边(动物轮廓、草丛):两张图都有,会被正确匹配,这是好事。
真正可能出问题的是:生成式模型在原位置生成出一条假边,而它恰好和别处某条真边长得像。这时会产生零星的错误匹配,ratio test 也挡不住。
这类错误匹配叫外点(outlier)。它们数量少、彼此之间毫无规律,而正确匹配都服从同一个几何变换。利用这一点,可以用 RANSAC 从混有外点的匹配里稳健地估计变换。这正是 下一篇 的内容。
自测题
- 为什么 SIFT 用 DoG 在多个尺度上找极值,而不是直接在原图上找角点?
参考答案
在单一尺度上找到的角点没有「尺度」这个属性:图像一缩放,同一个结构在原尺度上可能不再是角点,也无从知道该用多大的邻域去描述它。DoG 近似尺度归一化的拉普拉斯,在尺度空间里找极值,能给每个关键点同时确定位置和特征尺度,描述子就可以按这个尺度取邻域。另外,DoG 只是相邻两级模糊图相减,金字塔反正要建,计算很便宜。
- 把 ratio test 的阈值从 0.75 改成 0.6 或 0.9,匹配数会怎么变?各有什么代价?
参考答案
阈值越小,要求最近邻「赢得越明显」,条件越严格:0.6 时匹配数减少,留下的更可靠,但会误杀一些重复纹理上的正确匹配。0.9 时匹配数增加,但混进更多错误匹配,更依赖后续 RANSAC 去清理。
- 图缩小一半后关键点变少,是不是说明 SIFT 不是尺度不变的?
参考答案
不是。降采样抹掉了细纹理,检测到的点集合本来就会变化。尺度不变指的是两边都存活下来的稳定地标仍能通过描述子匹配上,可以看缩小前后之间有多少对点通过了 ratio test。
参考
- D. G. Lowe. Distinctive Image Features from Scale-Invariant Keypoints. IJCV, 2004.
- OpenCV 文档:Introduction to SIFT、Feature Matching
Enjoy Reading This Article?
Here are some more articles you might like to read next: